이 글의 핵심
- From HTML Entity로 문자 표현을 복원합니다.
- 일반 문자와 HTML 실행을 구분합니다.
- 변환된 내용을 웹에 넣을 때 다시 검수합니다.
01. 기호가 길게 보이는 이유
웹 문서에서 복사한 자료에 &나 <가 남아 있으면 글자가 깨졌다고 생각하기 쉽습니다. HTML에서 특정 문자를 표현하는 표기가 그대로 남은 경우일 수 있습니다. 이번에는 짧은 가상 문장으로 변환을 확인했습니다.
02. 직접 입력하기
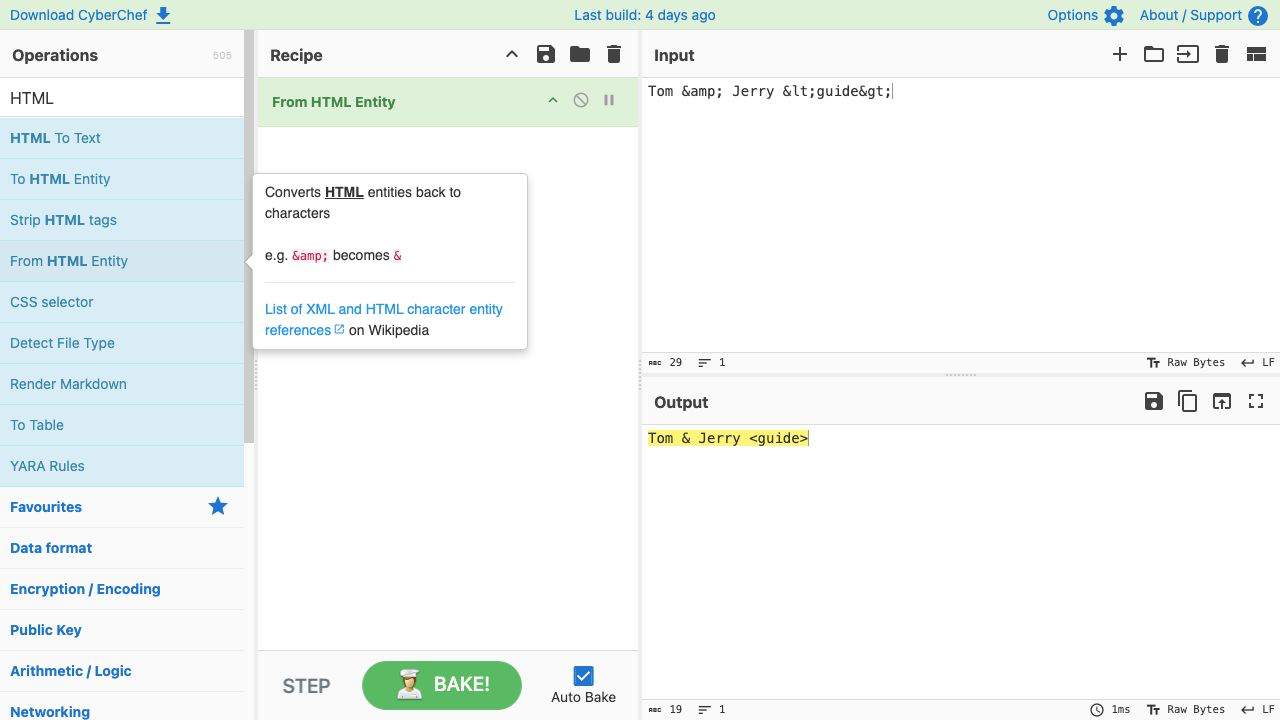
Input에 Tom & Jerry <guide>를 넣었습니다. Operations에서 HTML을 검색하고 From HTML Entity를 Recipe에 추가했습니다. 이전 변환을 지운 상태에서 한 기능만 사용했습니다. 실제 웹사이트의 코드를 긁어 오거나 실행하지 않았습니다.
03. 결과 확인
Output은 Tom & Jerry <guide>였습니다. 앰퍼샌드와 꺾쇠가 일반 문자로 표시됐습니다. 결과 화면에 나온 <guide>는 이 실습의 텍스트이며 실제 페이지에 삽입한 태그가 아닙니다. 문자를 복원하는 동작과 HTML을 실행하거나 렌더링하는 동작은 구분해야 합니다.
04. 반복 변환 주의
자료가 여러 번 인코딩된 것처럼 보여도 무작정 계속 디코딩하지 마세요. 어떤 문자를 원래대로 남겨야 하는지 모르면 의미를 바꿀 수 있습니다. 원본을 보관한 뒤 한 번 변환한 결과를 대조하고 필요한 범위만 처리하는 편이 좋습니다.
05. 게시 전 확인
변환 결과를 웹페이지에 넣을 때는 사용하는 편집기가 문자열을 어떻게 처리하는지 확인해야 합니다. 이 글에서는 문자 복원만 시험했으며 보안 필터나 HTML 정화 기능으로 사용한 것이 아닙니다. 알 수 없는 코드를 실행하거나 민감한 내용을 입력하지 마세요.
마지막으로 기억할 것
- From HTML Entity로 문자 표현을 복원합니다.
- 일반 문자와 HTML 실행을 구분합니다.
- 변환된 내용을 웹에 넣을 때 다시 검수합니다.
출처: 공식 자료·실습 출처 · 실습한 서비스